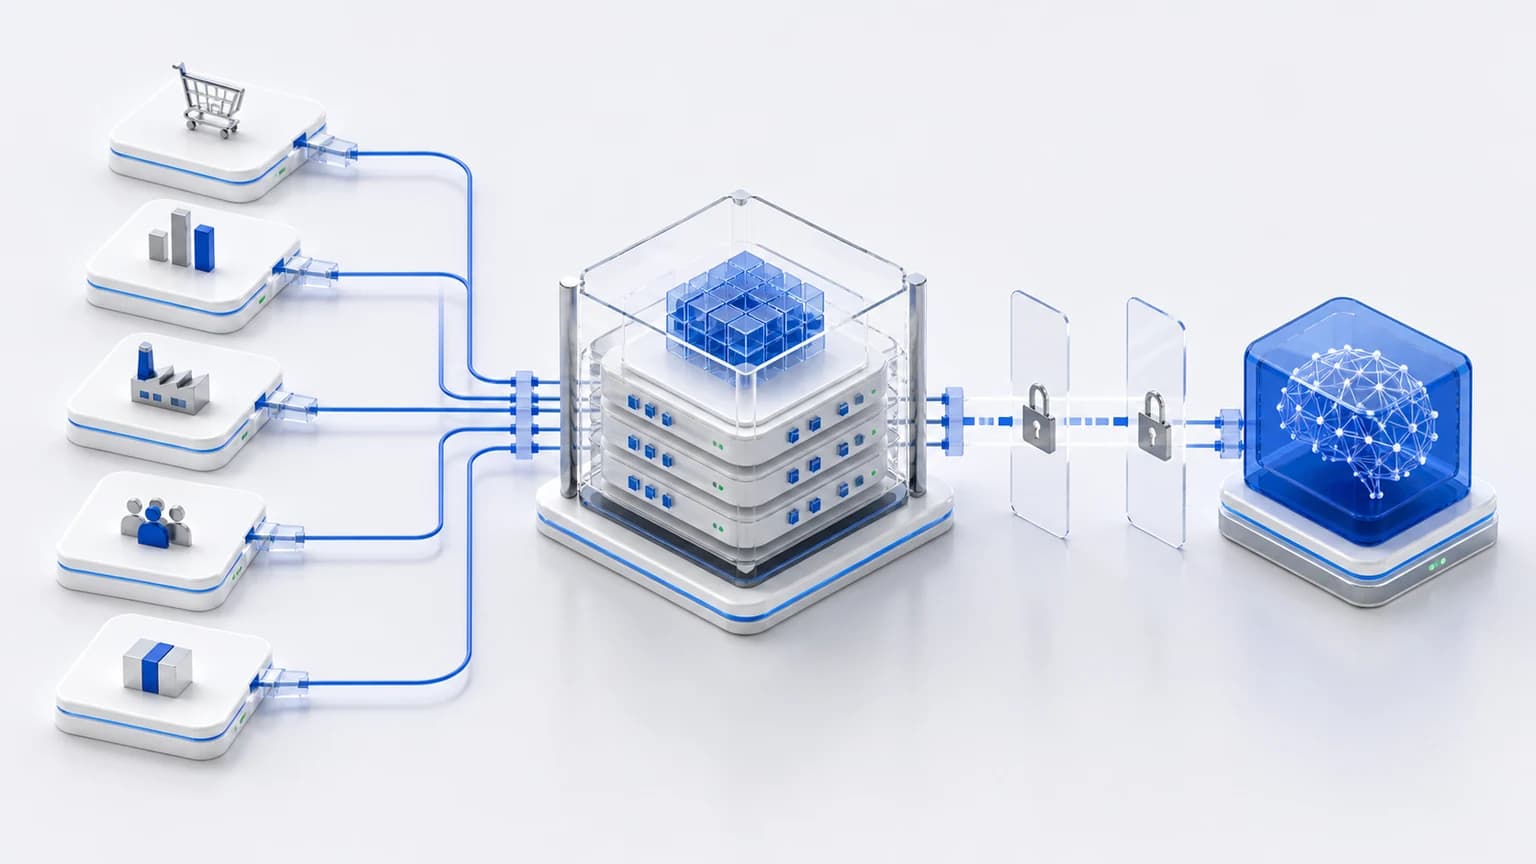
L’ERP concentre commandes, stocks, facturation, achats ou production. Le connecter à un agent IA ouvre des usages puissants, mais l’agent ne doit jamais devenir une porte d’accès générale au système. L’architecture doit séparer la compréhension en langage naturel, les règles métier et l’exécution technique.
Commencer par la lecture avant l’écriture
Un premier projet peut rechercher un statut, expliquer un écart, synthétiser un dossier ou préparer une action. Les modifications de commandes, paiements, stocks ou données maîtres viennent ensuite, avec des validations et des droits spécifiques.
Quatre architectures possibles
- API ERP : méthode privilégiée lorsque les opérations sont documentées.
- Couche d’intégration ou n8n : orchestration, validation et journalisation des étapes.
- Réplication en lecture : analyse sans exposer directement la base de production.
- RAG documentaire : procédures et documentation, en complément des données structurées.
Définir les permissions par action
Un compte technique distinct doit disposer du minimum de droits. Chaque action sensible exige une règle : montant maximal, rôle autorisé, environnement, double validation ou impossibilité d’exécution. Les secrets et jetons restent côté serveur.
Gérer la qualité et le contexte des données
Les codes, unités, statuts et historiques ERP sont rarement compréhensibles sans dictionnaire métier. L’agent doit connaître les définitions, mais aussi signaler ce qu’il ignore. Une réponse assortie de la source, de la date et du périmètre est préférable à une réponse fluide mais invérifiable.
Cas d’usage adaptés à un premier pilote
- Interroger le statut d’une commande ou d’un dossier.
- Préparer une synthèse client avant rendez-vous.
- Expliquer une rupture ou un retard à partir des événements disponibles.
- Créer un brouillon de demande d’achat soumis à validation.
- Comparer une facture, une commande et une réception.
- Alerter sur des anomalies selon des règles validées.
Tester et mesurer
Les tests doivent couvrir les erreurs d’API, les doublons, les données absentes, les permissions insuffisantes et les tentatives d’action hors périmètre. Mesurez le temps gagné, le taux de réponses exactes, les corrections, les actions annulées et la disponibilité du service.
La bonne première question
Ne demandez pas “comment mettre de l’IA dans notre ERP ?”. Demandez quelle décision ou tâche répétitive dépend aujourd’hui de données ERP, combien elle coûte et quel niveau d’erreur est acceptable. Cette formulation mène à un périmètre intégrable et à un ROI vérifiable.
Ne pas donner un accès global à l’ERP
L’agent doit utiliser des fonctions étroites et documentées : rechercher un client, lire l’état d’une commande, préparer une ligne de commentaire ou proposer une mise à jour. Un service intermédiaire vérifie les paramètres et les droits avant l’appel à l’ERP. Cette approche réduit les risques et facilite les tests.
Commencer par une opération réversible
- Lecture et synthèse avant toute écriture.
- Préparation d’une action plutôt qu’exécution immédiate.
- Validation obligatoire pour les montants, stocks et données sensibles.
- Identifiant d’opération pour éviter les doublons en cas de nouvelle tentative.
- Journal de l’entrée, de la règle appliquée et du résultat ERP.
Construire un jeu de tests métier
Les tests doivent couvrir les cas habituels, mais aussi les clients homonymes, références inconnues, devises différentes, champs obligatoires, droits insuffisants et indisponibilités de l’ERP. Le métier valide les résultats attendus ; l’équipe technique vérifie la robustesse, la sécurité et la reprise après erreur.
Piloter par les résultats opérationnels
Mesurez le temps économisé, les reprises, les erreurs évitées, le taux d’actions approuvées et la disponibilité du connecteur. Le modèle peut évoluer, mais ces indicateurs doivent rester comparables. Source méthodologique : https://www.francenum.gouv.fr/guides-et-conseils/intelligence-artificielle/comprendre-et-adopter-lia/comment-deployer-lia
Préparer un pilote qui permet une vraie décision
Un pilote n’est pas une démonstration isolée. Il doit fonctionner sur un échantillon représentatif, avec les utilisateurs concernés et les contraintes du futur environnement. Définissez avant son démarrage la durée, le nombre de cas, les critères d’acceptation, les personnes qui valident les résultats et les conditions d’arrêt. À la fin, la décision doit être claire : déployer, corriger un point précis, préparer les données ou abandonner.
Organiser les responsabilités après la mise en production
Le propriétaire métier suit la valeur et les usages. Le responsable technique surveille les connexions, les erreurs et les coûts. Le référent données ou conformité contrôle les sources, les droits et la conservation. Les utilisateurs disposent d’un canal pour signaler une réponse incorrecte ou un cas non prévu. Cette répartition simple évite qu’une solution soit déployée sans maintenance ni responsable identifié.
Questions à trancher avant de lancer le projet
- Quel indicateur prouvera que le processus s’est réellement amélioré ?
- Quelles données sont indispensables et qui autorise leur utilisation ?
- Quelles actions restent soumises à validation humaine ?
- Comment l’agent réagit-il si une source ou un outil est indisponible ?
- Qui examine les incidents, les retours utilisateurs et les évolutions ?
- Quel budget récurrent couvre les modèles, l’hébergement, le suivi et la maintenance ?
Cette discipline transforme une idée d’IA en projet d’entreprise gouverné. Elle permet aussi de comparer les solutions sur leur capacité à s’intégrer, à être contrôlées et à produire un résultat, plutôt que sur une simple démonstration du modèle.