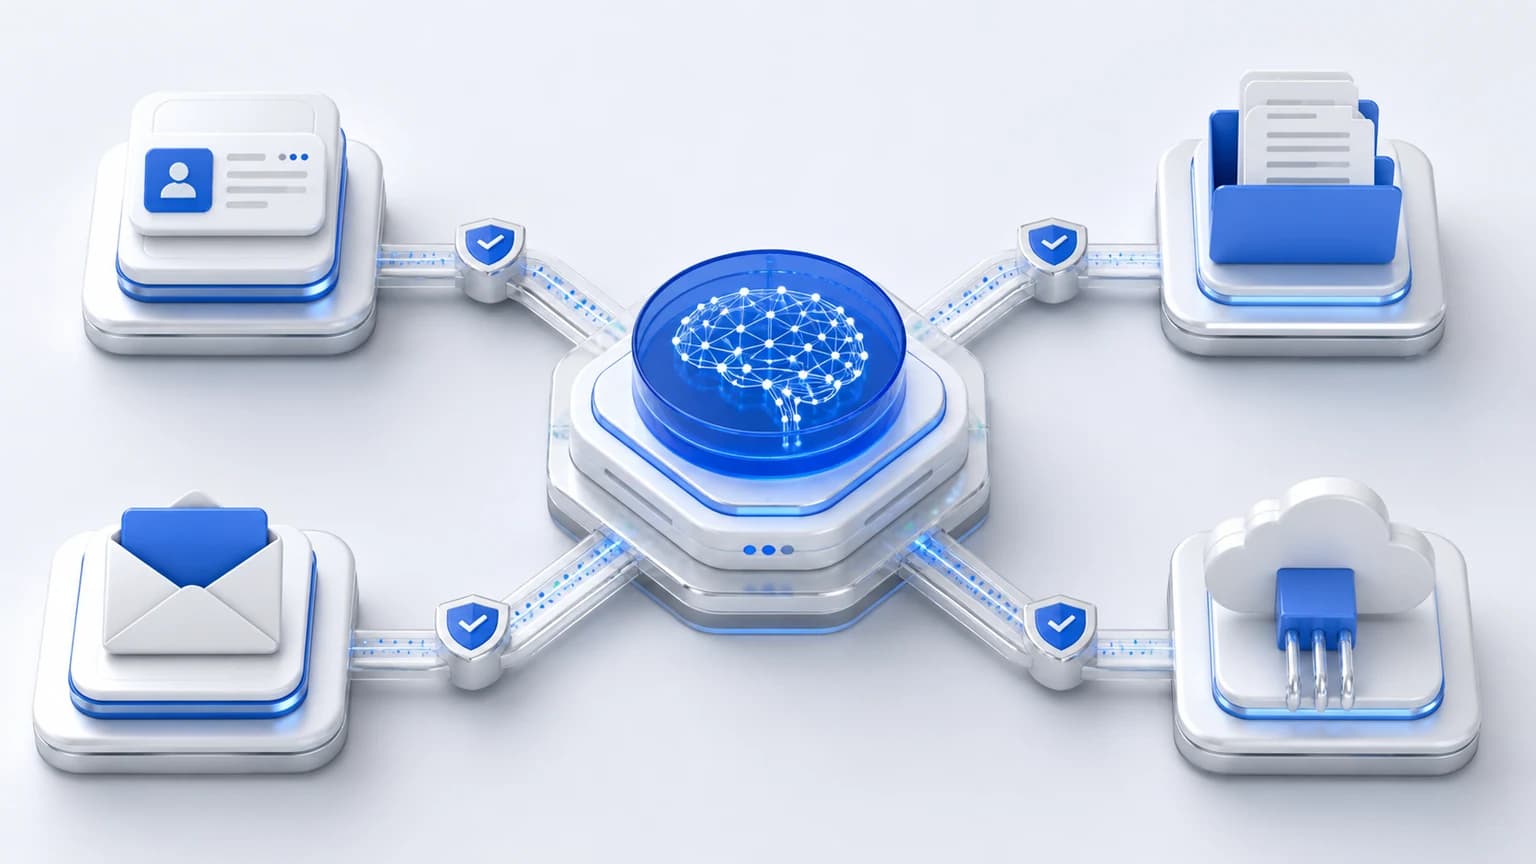
La valeur d’un agent IA apparaît lorsqu’il travaille avec les outils déjà utilisés par les équipes. Cette connexion doit cependant être conçue comme une intégration métier : chaque donnée lue, chaque action exécutée et chaque validation doivent être définies.
Séparer lecture, recommandation et action
Un premier niveau permet à l’agent de consulter des données. Un deuxième prépare une recommandation. Le troisième exécute une action autorisée. Cette progression limite les risques et permet de mesurer la qualité avant d’accorder davantage de droits.
Définir les droits par outil
- CRM : champs lisibles, modifiables et règles de déduplication.
- ERP : opérations autorisées, seuils et validations obligatoires.
- Documents : sources, versions, droits d’accès et citations.
- Messagerie et API : destinataires, volumes, secrets et journalisation.
Conserver une supervision humaine
Les actions sensibles restent soumises à validation. Les journaux permettent de comprendre la décision, la source utilisée et le résultat. Un mécanisme d’arrêt et une procédure de reprise sont prévus avant la mise en production.
Tester sur des cas réels
Le pilote doit couvrir les cas fréquents, les exceptions et les données incomplètes. Les indicateurs portent sur le temps gagné, la qualité, les erreurs évitées et l’adoption par les équipes.
Cartographier chaque lecture et chaque action
Une intégration fiable commence par une liste explicite des systèmes concernés : CRM, ERP, messagerie, stockage documentaire, outil de ticketing ou base de connaissances. Pour chacun, distinguez les données que l’agent peut lire, les champs qu’il peut proposer, les actions qu’il peut exécuter et celles qui exigent une confirmation. Cette cartographie devient le contrat fonctionnel de l’intégration.
Choisir le bon niveau d’autonomie
- Lecture seule : l’agent recherche et synthétise sans modifier le système.
- Préparation : il produit un brouillon ou une mise à jour soumise à validation.
- Exécution contrôlée : il agit dans un périmètre autorisé et conserve une trace.
- Escalade : il transmet le cas à une personne lorsque le risque ou l’incertitude dépasse le seuil défini.
Le niveau d’autonomie doit dépendre du coût d’une erreur, pas de la seule capacité technique du modèle. Une mise à jour de commentaire CRM et une validation de facture n’appellent pas les mêmes garde-fous.
Séparer orchestration, modèle et systèmes métier
L’architecture gagne en robustesse lorsque le modèle ne possède pas directement tous les droits. Une couche d’orchestration vérifie l’identité, les permissions, les formats et les règles métier avant d’appeler une API. Elle journalise ensuite l’action, la réponse et la validation éventuelle. Cette séparation facilite le changement de modèle et limite l’impact d’une réponse incorrecte.
Tester les cas nominaux et les cas d’échec
- Donnée absente, ambiguë ou contradictoire.
- API indisponible, lente ou limitée en volume.
- Utilisateur sans droit suffisant.
- Document mal classé ou version obsolète.
- Réponse incertaine nécessitant une escalade humaine.
- Nouvelle tentative qui ne doit pas créer de doublon.
Mesurer la qualité de l’intégration en production
Suivez le taux de succès des appels, les erreurs par connecteur, les reprises manuelles, le délai de traitement et les actions annulées. France Num insiste sur une adoption progressive, des objectifs mesurables et une implication des équipes. Source officielle : https://www.francenum.gouv.fr/guides-et-conseils/intelligence-artificielle/comprendre-et-adopter-lia/comment-deployer-lia
Préparer un pilote qui permet une vraie décision
Un pilote n’est pas une démonstration isolée. Il doit fonctionner sur un échantillon représentatif, avec les utilisateurs concernés et les contraintes du futur environnement. Définissez avant son démarrage la durée, le nombre de cas, les critères d’acceptation, les personnes qui valident les résultats et les conditions d’arrêt. À la fin, la décision doit être claire : déployer, corriger un point précis, préparer les données ou abandonner.
Organiser les responsabilités après la mise en production
Le propriétaire métier suit la valeur et les usages. Le responsable technique surveille les connexions, les erreurs et les coûts. Le référent données ou conformité contrôle les sources, les droits et la conservation. Les utilisateurs disposent d’un canal pour signaler une réponse incorrecte ou un cas non prévu. Cette répartition simple évite qu’une solution soit déployée sans maintenance ni responsable identifié.
Questions à trancher avant de lancer le projet
- Quel indicateur prouvera que le processus s’est réellement amélioré ?
- Quelles données sont indispensables et qui autorise leur utilisation ?
- Quelles actions restent soumises à validation humaine ?
- Comment l’agent réagit-il si une source ou un outil est indisponible ?
- Qui examine les incidents, les retours utilisateurs et les évolutions ?
- Quel budget récurrent couvre les modèles, l’hébergement, le suivi et la maintenance ?
Cette discipline transforme une idée d’IA en projet d’entreprise gouverné. Elle permet aussi de comparer les solutions sur leur capacité à s’intégrer, à être contrôlées et à produire un résultat, plutôt que sur une simple démonstration du modèle.